Financement circulaire de l'IA, guerre CUDA vs TPU/Trainium et parité de risque : Audit d'un portefeuille mondial
Enquête analytique globale sur les flux croisés Hyperscalers/GPU/LLM (NVIDIA, Amazon, Google, Anthropic), impact du multi-puces (CUDA vs AWS Trainium et Google TPU) sur les marges brutes et construction d'une allocation internationale en parité de risque.
Dernière révision méthodologique :
Recherche Quantitative · Lab Quant
Planificateur d'Allocation ETF
Illustration éditoriale — TrueVerdikt
DANS CET ARTICLE
Points clés à retenir (TL;DR)
- Le financement circulaire de l'IA repose sur une boucle de capitaux croisés : les hyperscalers investissent des milliards dans les laboratoires LLM (Anthropic), qui convertissent ces fonds en achats de calcul cloud et de puces IA.
- La stratégie multi-puces d'Anthropic (ANT), entraînant Claude sur AWS Trainium et Google TPU aux côtés des GPU NVIDIA, menace progressivement le pouvoir de fixation des prix et les marges brutes (~70–75 %) de l'écosystème CUDA.
- Dans un portefeuille mondial pondéré par la capitalisation, détenir simultanément NVIDIA, Amazon, Alphabet et Anthropic crée une exposition redondante au même cycle CapEx IA.
- L'allocation en parité de risque (ERC — Equal Risk Contribution) égalise mathématiquement la contribution de chaque bloc à la volatilité totale, protégeant le portefeuille contre un retournement simultané de la chaîne IA.
À mesure que les marchés mondiaux digèrent simultanément l'introduction en bourse record d'Anthropic (ANT, 81 milliards $ US) et le choc de gouvernance affectant NVIDIA (NVDA) en cette fin novembre 2026, une question structurelle s'impose chez les analystes institutionnels de New York, Londres, Francfort, Singapour et Toronto : quelle part de la croissance spectaculaire du chiffre d'affaires de l'infrastructure IA provient d'une demande finale rentable des entreprises, et quelle part relève d'un mécanisme de financement circulaire entre une poignée de géants ?
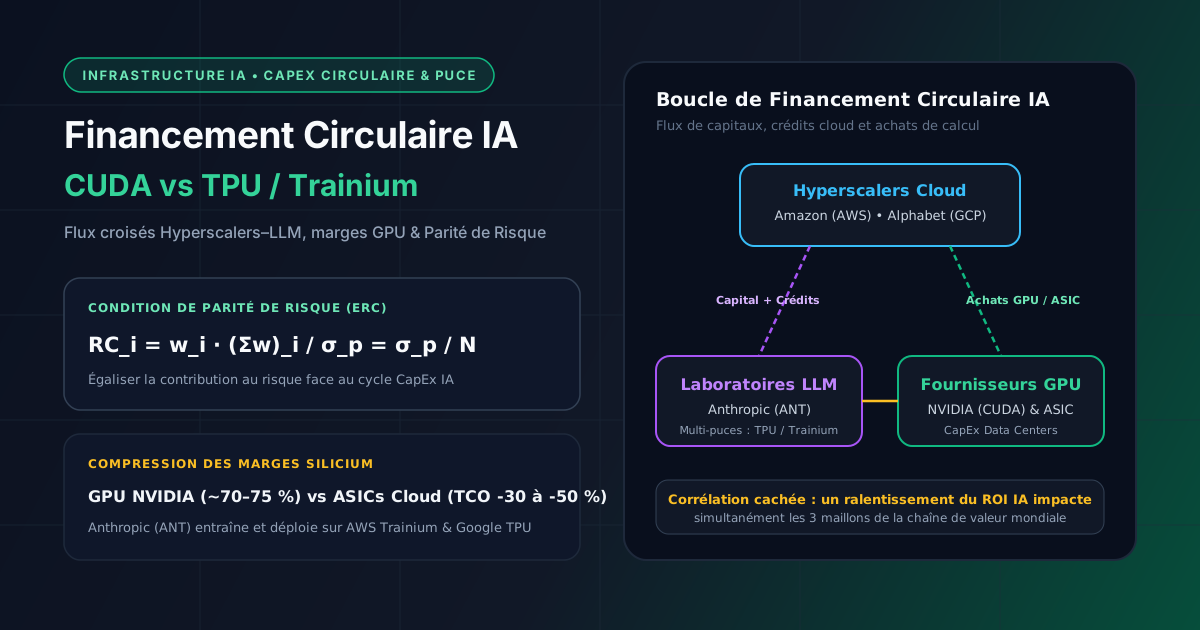
L'écosystème mondial de l'intelligence artificielle générative s'est bâti sur un maillage financier inédit. Les hyperscalers cloud (Amazon/AWS, Alphabet/Google Cloud, Microsoft Azure) ont injecté des dizaines de milliards de dollars en capital et en crédits de calcul dans les laboratoires LLM (comme Anthropic), lesquels reversent l'essentiel de ces capitaux aux mêmes fournisseurs cloud pour louer d'immenses grappes de serveurs équipées de GPU NVIDIA ou de puces personnalisées (AWS Trainium, Google TPU). Ce bouclage financier amplifie la visibilité des revenus en phase d'expansion, mais crée une corrélation systémique cachée dès que la rentabilité finale (ROI) des clients entreprises ralentit.
Cette enquête analytique décortique la mécanique du financement circulaire, évalue l'impact concurrentiel de la transition multi-puces (CUDA vs TPU / Trainium) sur les marges brutes des semi-conducteurs, et formalise la construction d'un portefeuille international en parité de risque (ERC) à l'aide des équations de contribution marginale au risque.
Pour structurer votre allocation FNB internationale et diagnostiquer vos expositions croisées aux facteurs technologiques, explorez notre Planificateur de Portefeuille FNB et l'Analyseur de Risque de Portefeuille.
1. Anatomie du financement circulaire : la boucle Hyperscalers – LLM – Silicium
Dans les documents réglementaires déposés auprès de la SEC (Form 10-K d'Amazon, d'Alphabet et de NVIDIA, ainsi que le Form S-1 d'Anthropic), les flux financiers entre les trois maillons de la chaîne de valeur IA dessinent une boucle semi-fermée :
- Étape 1 (Injection de capital et crédits cloud) : Amazon (~8 milliards $ US) et Alphabet (>3 milliards $ US) investissent au capital d'Anthropic tout en structurant des engagements pluriannuels d'utilisation d'infrastructure cloud.
- Étape 2 (Consommation de calcul et revenus cloud) : Anthropic utilise ses financements et les fonds levés lors de son IPO pour entraîner et inférer ses modèles Claude sur AWS et Google Cloud, générant une croissance immédiate du chiffre d'affaires déclaré par les divisions cloud.
- Étape 3 (Achats massifs de silicium / CapEx) : Pour honorer ces contrats de calcul, les hyperscalers consacrent des budgets d'investissement (CapEx) historiques à l'achat d'accélérateurs GPU (NVIDIA) et au déploiement de leurs propres puces ASIC (Trainium, TPU).
Sur le plan économique, ce cycle n'est pas intrinsèquement illégitime — il rappelle les mécanismes historiques de financement fournisseurs (vendor financing) observés lors du déploiement des réseaux de télécommunications à la fin des années 1990. Toutefois, il introduit un risque de double comptage macroéconomique : si la monétisation finale par les entreprises clientes (abonnements logiciels, gains de productivité mesurables) progresse plus lentement que les amortissements de centres de données, les trois maillons (fournisseurs GPU, hyperscalers et laboratoires LLM) subissent une révision simultanée de leurs multiples.
2. Guerre des puces : CUDA (NVIDIA) face aux ASICs propriétaires (TPU & Trainium)
Jusqu'en 2024–2025, la plateforme logicielle CUDA de NVIDIA conférait un quasi-monopole de fait sur l'entraînement des grands modèles de langage, permettant à NVIDIA d'afficher des marges brutes exceptionnelles de 70 % à 75 % — un niveau historiquement rarissime pour un fabricant de matériel semi-conducteur.
En 2026, l'architecture multi-puces déployée par des acteurs majeurs comme Anthropic (ANT) modifie profondément l'équilibre économique du silicium :
- Google TPU (Tensor Processing Units) : conçues spécifiquement pour les opérations matricielles de l'apprentissage profond et intégrées nativement au réseau optique de Google Cloud, elles réduisent la dépendance aux marges commerciales d'un fournisseur tiers.
- AWS Trainium & Inferentia : déployées à grande échelle par Amazon pour l'entraînement et l'inférence des modèles Claude, elles visent une réduction du coût total de possession (Total Cost of Ownership, TCO) de 30 % à 50 % par watt et par jeton généré (token) par rapport aux grappes GPU généralistes.
Modélisons l'impact d'une migration progressive des charges d'inférence vers des ASICs sur la marge brute consolidée d'un fournisseur GPU dominant. Si désigne le prix moyen de vente, le coût unitaire de fonderie/HBM, et la part de marché conservée face à une pression tarifaire imposée par la concurrence ASIC, la marge brute réagit de manière non linéaire :
Ainsi, pour un coût de fabrication représentant du prix initial (), une simple concession tarifaire de destinée à défendre les parts de marché face aux TPU et Trainium ramène la marge brute à :
Une compression de 480 points de base de la marge brute suffit, dans un modèle de valorisation à multiple élevé, à contracter significativement les prévisions de flux de trésorerie futurs — expliquant la nervosité des marchés mondiaux face à la guerre du silicium.
3. Tableau comparatif : Écosystèmes matériels IA et impact sur les portefeuilles
| Dimension stratégique & financière | NVIDIA GPU + CUDA | Google Cloud TPU (ASIC) | AWS Trainium / Inferentia (ASIC) |
|---|---|---|---|
| Modèle économique | Vente directe de puces & racks (marge élevée) | Usage interne + location Google Cloud | Usage interne + location AWS Bedrock |
| Marge brute matériel / TCO | ~70 % à 75 % (pouvoir de prix historique) | TCO interne optimisé (-30 % à -45 %) | TCO inférence optimisé (-30 % à -50 %) |
| Écosystème logiciel | CUDA (standard universel, fort lock-in) | JAX / PyTorch XLA (optimisé DeepMind/LLM) | AWS Neuron SDK (partenariat étroit Anthropic) |
| Clientèle & flexibilité | Universelle (tous clouds, souverains, entreprises) | Captive à Google Cloud (Alphabet) | Captive à Amazon Web Services (Amazon) |
| Risque boursier principal | Compression de marge + concentration client | CapEx élevé + concurrence cloud | Dépréciation rapide + guerre des prix IA |
4. Construire un portefeuille mondial en Parité de Risque (ERC)
L'erreur classique d'un investisseur international (européen, américain, asiatique ou canadien) consiste à croire qu'acheter séparément NVDA, AMZN, GOOGL et ANT diversifie son exposition à l'intelligence artificielle. Comme le démontre la boucle de financement circulaire, ces quatre titres partagent un facteur de risque commun dominant.
Pour briser cette concentration cachée, l'approche institutionnelle de Parité de Risque (Equal Risk Contribution, ERC), formalisée par Maillard, Roncalli et Teïletche (2010), remplace la pondération par capitalisation boursière par une égalisation mathématique des contributions au risque de chaque classe d'actifs (Actions US/Tech, Actions Internationales hors US, Obligations souveraines, Matières premières / Or).
Soit le vecteur des pondérations et la matrice de covariance des rendements. La volatilité totale du portefeuille est . Par le théorème d'Euler sur les fonctions homogènes de degré 1, la volatilité totale se décompose exactement en la somme des contributions individuelles :
Le portefeuille en Parité de Risque résout le programme d'optimisation tel que chaque bloc contribue exactement à de la volatilité totale :
Dans un univers à 4 blocs mondiaux, alors qu'un portefeuille traditionnel « 60/40 » ou un indice mondial pondéré par capitalisation concentre souvent 85 % à 92 % de sa variance totale dans les actions (et une part disproportionnée dans le cycle CapEx IA américain), l'architecture ERC ramène mécaniquement la contribution de chaque bloc à 25 % du risque total.
Pour comparer concrètement votre allocation actuelle (pondérée par capitalisation) face à une structure équilibrée en risque, vous pouvez modéliser vos FNB dans notre Planificateur de Portefeuille FNB puis vérifier la décomposition exacte de votre volatilité dans l'Analyseur de Risque de Portefeuille.
Sources primaires et références académiques
- U.S. Securities and Exchange Commission (SEC) — EDGAR — Form 10-K Annual Reports de NVIDIA Corporation, Amazon.com, Inc. et Alphabet Inc., ainsi que le Form S-1 d'Anthropic PBC (engagements cloud, accords multi-puces et dépenses CapEx).
- Reuters & The Guardian (novembre 2026) — Enquêtes économiques sur les flux de financement croisés entre hyperscalers, créateurs de LLM et fournisseurs de semi-conducteurs IA.
- Maillard, S., Roncalli, T., & Teïletche, J. (2010) — "The Properties of Equally Weighted Risk Contribution Portfolios", The Journal of Portfolio Management, 36(4), 60–70.
- S&P Dow Jones Indices & MSCI — Rapports sur la concentration sectorielle et la covariance des méga-capitalisations technologiques dans les indices mondiaux.
Avertissement analytique : Cette étude est publiée exclusivement à des fins d'information économique et d'éducation financière quantitative. Elle ne constitue ni un conseil en investissement personnalisé ni une recommandation portant sur NVIDIA, Amazon, Alphabet ou Anthropic.
Planificateur d'Allocation ETF
Simulez la projection déterministe de vos versements ETF et structurez votre allocation par enveloppe fiscale.
Construire un plan ETFAuteur & Responsable Méthodologique
Alain Legrand
Fondateur & Ingénieur Financier Quantitatif · TrueVerdikt
Ingénieur financier indépendant basé au Québec (Canada), Alain Legrand conçoit et audite les modèles déterministes de TrueVerdikt : comparaison des frais RFG Série A/F et FNB TSX, arbitrage fiscal REER/CELIAPP, actuariat hypothécaire canadien et détection statistique du surapprentissage (Deflated Sharpe Ratio & CPCV).
Sources primaires & références vérifiées
- BSIF (OSFI) — Ligne directrice B-20 — Pratiques et procédures saines en matière de souscription de prêts hypothécaires résidentiels et test de tension (stress-test).
- ARC (CRA) — CELIAPP, REER & RAP — Plafonds officiels de cotisation (8 000 $/an, 40 000 $ à vie pour le CELIAPP), déductions fiscales et règles du RAP.
- CIFSC — Comité des normes des fonds d'investissement du Canada — Catégorisation normalisée des fonds communs de placement et FNB canadiens utilisée dans notre comparateur RFG.
- Bailey & López de Prado (2014) — The Deflated Sharpe Ratio — Correcting for Selection Bias, Backtest Overfitting, and Non-Normality. The Journal of Portfolio Management, 40(5), 94–107 (SSRN).

Acheter NVIDIA (NVDA) et Anthropic (ANT) en USD depuis le Canada : Frais de change, Norbert's Gambit, CDR et fiscalité REER/CELI

IPO record d'Anthropic (ANT, 81 Md$) et sell-off mondial de l'IA : Valorisation, CapEx et discipline de rééquilibrage