Backtester en Python avec Claude (Anthropic) : 5 pièges d'overfitting silencieux et Deflated Sharpe Ratio
Audit quantitatif des 5 biais critiques fréquents dans les backtests Python générés par LLM (look-ahead bias, survivorship bias, data snooping, coûts omis, fuite train/test), correctifs Python propres et équations du Deflated Sharpe Ratio (DSR).
Dernière révision méthodologique :
Recherche Quantitative · Lab Quant
Analyseur de Backtest & DSR
Illustration éditoriale — TrueVerdikt
DANS CET ARTICLE
Points clés à retenir (TL;DR)
- Les modèles de langage comme Claude accélèrent l'écriture de scripts pandas/NumPy, mais génèrent fréquemment des backtests présentant un Ratio de Sharpe artificiellement gonflé par des biais d'implémentation silencieux.
- Cinq pièges dominent les prototypes générés par LLM : biais d'anticipation (look-ahead), biais du survivant, data snooping par recherche de grille, omission du slippage et fuite temporelle dans la normalisation.
- Le Deflated Sharpe Ratio (DSR) de Bailey et López de Prado corrige le Sharpe observé en fonction du nombre d'essais N, de l'asymétrie (skewness) et de l'aplatissement (kurtosis) des rendements.
- Chaque stratégie codée en Python doit être soumise à un décalage strict des signaux (.shift(1)), à une modélisation réaliste des coûts de transaction et à une validation hors échantillon purgée.
L'utilisation d'assistants de programmation avancés comme Claude (Anthropic) a transformé le flux de travail des chercheurs quantitatifs et des investisseurs systématiques. En quelques secondes, il est désormais possible de générer un script Python complet utilisant pandas, numpy et scipy pour tester une stratégie de momentum, de retour à la moyenne ou de rotation sectorielle.
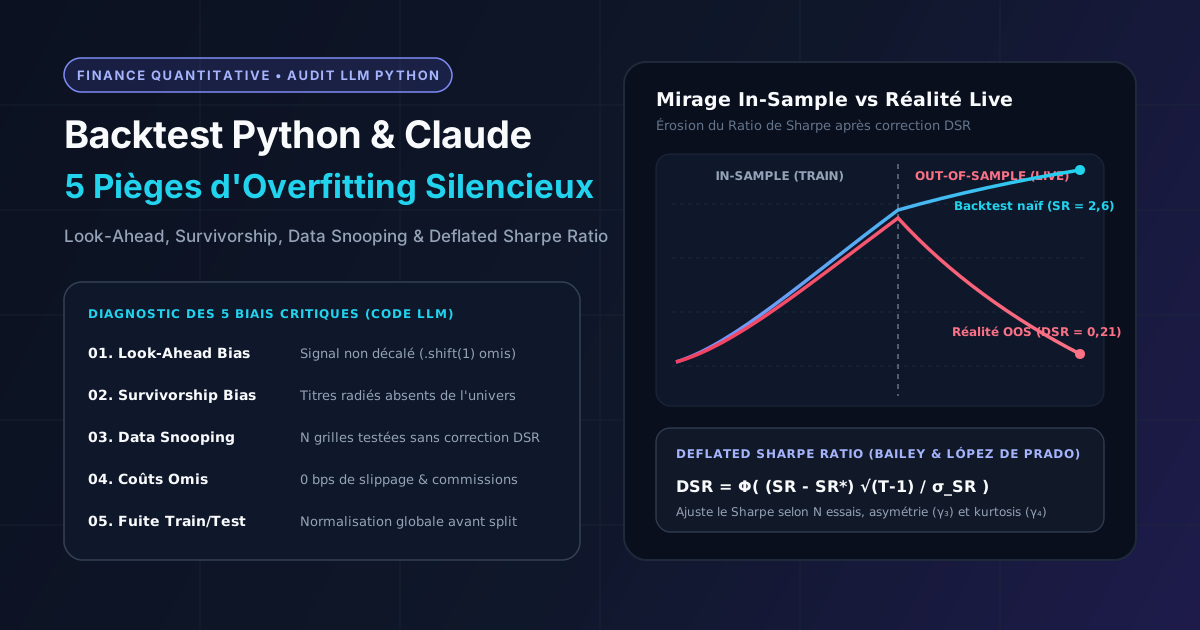
Pourtant, cette productivité s'accompagne d'un paradoxe bien connu en économétrie financière : un code Python syntaxiquement impeccable et sans aucune erreur d'exécution peut produire un backtest mathématiquement invalide. Parce qu'un grand modèle de langage (LLM) optimise la vraisemblance textuelle et la clarté pédagogique d'un script, il omet fréquemment les garde-fous micro-structurels indispensables en finance quantitative. Le résultat est une courbe d'équité qui grimpe linéairement en simulation historique (in-sample) avec un Ratio de Sharpe supérieur à 2,5, avant de s'effondrer dès son déploiement réel (out-of-sample).
Cette étude dissèque les 5 pièges d'overfitting et de fuite de données les plus courants dans un backtest Python assisté par LLM, propose les correctifs de code vérifiés pour chacun, et détaille l'équation du Deflated Sharpe Ratio (DSR) permettant de distinguer un véritable signal statistique d'un mirage algorithmique. Vous pouvez tester vos propres séries de rendements dans notre Analyseur de Backtest et approfondir ces concepts statistiques avec le Quant Educator.
1. Piège n° 1 : Le biais d'anticipation (Look-Ahead Bias)
Le look-ahead bias survient dès qu'une décision d'achat ou de vente à la date utilise une information qui n'est connue qu'à la clôture de la séance (ou ultérieurement). Dans les scripts pandas générés rapidement, l'erreur la plus classique consiste à multiplier directement le signal calculé sur le cours de clôture du jour par le rendement de ce même jour , en oubliant l'opérateur .shift(1).
import numpy as np
import pandas as pd

def backtest_moving_average(close: pd.Series, fast: int = 20, slow: int = 100) -> pd.DataFrame:
    """Compare une exécution biaisée (look-ahead) à une exécution causale valide."""
    returns = close.pct_change().fillna(0.0)
    sma_fast = close.rolling(window=fast, min_periods=fast).mean()
    sma_slow = close.rolling(window=slow, min_periods=slow).mean()

    # Signal calculé à la clôture du jour t (1 = investi, 0 = hors marché)
    raw_signal = (sma_fast > sma_slow).astype(float)

    # ERREUR CLASSIQUE : utilise le signal de clôture t sur le rendement du jour t
    biased_returns = raw_signal * returns

    # CORRECTIF CAUSAL : le signal de clôture t n'est exécuté qu'au jour t+1
    causal_position = raw_signal.shift(1).fillna(0.0)
    valid_returns = causal_position * returns

    return pd.DataFrame(
        {
            "biased_equity": (1.0 + biased_returns).cumprod(),
            "valid_equity": (1.0 + valid_returns).cumprod(),
            "position": causal_position,
        }
    )
Sur une stratégie de retour à la moyenne à court terme (comme un oscillateur RSI calculé sur la clôture), l'omission d'un seul .shift(1) suffit à transformer une stratégie perdante en un backtest affichant un rendement annualisé fictif de +30 %.
2. Piège n° 2 : Le biais du survivant (Survivorship Bias)
Lorsqu'un utilisateur demande à un LLM un script pour tester une stratégie multi-actions sur le S&P 500 ou le Nasdaq-100, le code télécharge presque systématiquement la liste actuelle des constituants de l'indice (par exemple les membres actuels du Nasdaq-100 incluant NVIDIA, Palantir ou CrowdStrike) et remonte 10 ou 15 ans en arrière.
Ce faisant, l'univers de test exclut mécaniquement toutes les sociétés qui figuraient dans l'indice en 2012 ou 2018 avant d'être radiées, rachetées à vil prix ou expulsées après une chute de 80 %. Ce filtre rétrospectif gonfle artificiellement le rendement annuel moyen de 150 à 400 points de base sur les stratégies value ou small-cap, et sous-estime massivement le Maximum Drawdown historique. Pour éliminer ce biais, le backtest doit impérativement s'appuyer sur une base de données point-in-time (constituants historiques datés) incluant les titres radiés (delisted securities).
3. Piège n° 3 : Le Data Snooping et le biais de tests multiples
Avec Python et un assistant IA, il devient trivial d'écrire une double boucle testant ou combinaisons de fenêtres de moyennes mobiles, de seuils de volatilité ou de filtres macroéconomiques, puis de conserver uniquement le jeu de paramètres qui maximise le Ratio de Sharpe historique.
En statistique, sélectionner le maximum de stratégies indépendantes (même purement aléatoires, sans aucun alpha réel) garantit mathématiquement l'apparition de faux positifs. Pour corriger cette inflation statistique, David H. Bailey et Marcos López de Prado (2014) ont introduit le Deflated Sharpe Ratio (DSR), qui exprime la probabilité que le véritable Ratio de Sharpe de la stratégie soit strictement positif après avoir pris en compte le nombre d'essais , la longueur de l'échantillon et la non-normalité des rendements (asymétrie et kurtosis ).
La première étape consiste à estimer le Ratio de Sharpe maximum attendu sous l'hypothèse nulle (aucun alpha réel) parmi essais indépendants de variance :
où est la constante d'Euler-Mascheroni, la base du logarithme naturel et la fonction quantile de la loi normale centrée réduite.
La seconde étape calcule le Deflated Sharpe Ratio comme la probabilité cumulée que le Sharpe observé dépasse ce seuil de bruit :
Un backtest affichant un Sharpe brut de 1,80 sur jours de bourse après avoir exploré variantes de paramètres, avec une asymétrie négative () et des queues épaisses (), voit fréquemment son DSR tomber sous 0,50 — signifiant que la performance est indiscernable du bruit pur.
import numpy as np
from scipy.stats import kurtosis, norm, skew

def deflated_sharpe_ratio(
    returns: np.ndarray,
    n_trials: int,
    sr_trials_std: float = 0.5,
) -> dict[str, float]:
    """Calcule le Deflated Sharpe Ratio (Bailey & López de Prado, 2014)."""
    r = np.asarray(returns, dtype=float)
    r = r[~np.isnan(r)]
    t_obs = len(r)
    if t_obs < 30 or n_trials < 1:
        raise ValueError("Requiert au moins 30 observations et n_trials >= 1.")

    sr_obs = float(np.mean(r) / np.std(r, ddof=1))
    g3 = float(skew(r))
    g4 = float(kurtosis(r, fisher=False))  # Kurtosis total (3.0 pour loi normale)

    euler_gamma = 0.5772156649
    if n_trials == 1:
        sr_zero = 0.0
    else:
        z1 = norm.ppf(1.0 - 1.0 / n_trials)
        z2 = norm.ppf(1.0 - 1.0 / (n_trials * np.e))
        sr_zero = sr_trials_std * ((1.0 - euler_gamma) * z1 + euler_gamma * z2)

    denom = np.sqrt(max(1e-12, 1.0 - g3 * sr_obs + ((g4 - 1.0) / 4.0) * (sr_obs ** 2)))
    z_score = (sr_obs - sr_zero) * np.sqrt(t_obs - 1) / denom
    dsr_prob = float(norm.cdf(z_score))

    return {
        "sr_non_annualized": sr_obs,
        "sr_annualized": sr_obs * np.sqrt(252.0),
        "sr_threshold_zero": float(sr_zero),
        "dsr_probability": dsr_prob,
    }
4. Piège n° 4 : Omission du slippage, des commissions et du taux de rotation
Dans la majorité des backtests de démonstration générés par un LLM, les rendements nets sont supposés égaux aux rendements bruts. Or, dès qu'une stratégie présente une rotation quotidienne élevée (turnover), les frictions d'exécution — écart acheteur-vendeur (bid-ask spread), glissement de prix (slippage) et commissions de courtage — érodent implacablement l'espérance mathématique.
Si représente la position cible à la date et le coût proportionnel par sens de transaction (par exemple , soit 10 points de base pour couvrir spread et slippage sur actions liquides), le rendement net doit soustraire la variation absolue de position :
import pandas as pd

def apply_transaction_costs(
    position: pd.Series,
    asset_returns: pd.Series,
    cost_bps: float = 10.0,
) -> pd.Series:
    """Applique commissions et slippage proportionnels au turnover effectif."""
    cost_rate = cost_bps / 10_000.0
    turnover = position.diff().abs().fillna(position.abs())
    gross_returns = position.shift(1).fillna(0.0) * asset_returns
    net_returns = gross_returns - turnover * cost_rate
    return net_returns
Une stratégie effectuant 120 allers-retours par an avec un coût réaliste de 10 bps par sens subit un handicap annuel mécanique de 2,40 % — suffisant pour faire basculer une stratégie de mean-reversion du positif au négatif.
5. Piège n° 5 : Fuite temporelle dans la normalisation (Train/Test Leakage)
Lorsqu'un script intègre des modèles d'apprentissage automatique (scikit-learn, XGBoost ou régression pénalisée) pour prédire les rendements, une erreur redoutable consiste à standardiser les variables explicatives (StandardScaler().fit_transform(X)) ou à sélectionner les features sur l'ensemble du jeu de données avant de découper les périodes d'entraînement (train) et de test (test).
Cette opération injecte la moyenne et l'écart-type futurs dans les observations passées. De plus, l'utilisation d'une validation croisée aléatoire (KFold(shuffle=True)) sur des séries temporelles financières brise l'ordre chronologique et permet au modèle d'apprendre à partir d'observations situées quelques jours après la date prédite. La pratique quantitative rigoureuse impose une validation croisée temporelle glissante (Walk-Forward) avec zone d'embargo (Purged Walk-Forward), où chaque transformation statistique est ajustée strictement sur la fenêtre d'entraînement passée (fit sur train, transform sur test).
6. Synthèse des 5 pièges et protocole de remédiation
| Piège de backtest LLM | Symptôme typique dans le code Python | Impact sur le Ratio de Sharpe | Remédiation quantitative rigoureuse |
|---|---|---|---|
| 1. Look-Ahead Bias | signal * returns sans décalage temporel |
Gonflement extrême (+1,0 à +3,0 SR) | Décaler systématiquement via .shift(1) et vérifier l'horodatage d'exécution |
| 2. Survivorship Bias | Liste actuelle du S&P 500 / Nasdaq-100 sur 10+ ans | Surévaluation du rendement (+1,5 % à +4 %/an) | Utiliser des constituants historiques point-in-time incluant les titres radiés |
| 3. Data Snooping | Optimisation par grille sur paramètres | Faux positifs garantis (mirage in-sample) | Calculer le Deflated Sharpe Ratio (DSR) et limiter l'espace des paramètres |
| 4. Coûts de transaction omis | Absence de coût sur position.diff().abs() |
Illusoire sur stratégies à fort turnover | Modéliser spread + slippage + commissions (5 à 25 bps/sens selon liquidité) |
| 5. Fuite Train/Test | StandardScaler().fit_transform(X) global ou shuffle=True |
Corrélation artificielle hors échantillon | Pipeline Walk-Forward purgé (fit uniquement sur passé + embargo) |
7. Checklist opérationnelle avant tout déploiement
Avant d'accorder le moindre crédit statistique à un backtest Python produit avec l'aide de Claude ou de tout autre LLM, un audit en quatre étapes s'impose :
- Audit de causalité : inspecter chaque série de signaux, moyennes mobiles, rééquilibrages et indicateurs fondamentaux pour garantir qu'aucune donnée de clôture n'est exécutée avant .
- Test de sensibilité aux coûts : doubler le paramètre
cost_bps(ex. de 10 bps à 20 bps) et vérifier si le Ratio de Sharpe reste économiquement significatif. - Calcul du DSR : enregistrer honnêtement le nombre total d'hypothèses et de jeux de paramètres testés durant la recherche, puis évaluer la probabilité DSR via notre Analyseur de Backtest.
- Validation hors échantillon : conserver une période récente strictement intacte (jamais consultée durant le calibrage) et utiliser le Quant Educator pour interpréter l'asymétrie, la kurtosis et le risque de ruine associés.
Les LLM accélèrent le codage, mais la rigueur économétrique incombe au chercheur — surtout lors des ruptures de volatilité comme l'IPO d'Anthropic (ANT, +17 % puis -9 % à -11 %) et le recul de ~14 % de NVDA autour du 20 novembre 2026.
Sources primaires et références académiques
- Bailey, D. H., & López de Prado, M. (2014) — "The Deflated Sharpe Ratio: Correcting for Selection Bias, Backtest Overfitting, and Non-Normality", The Journal of Portfolio Management, 40(5), 94–107.
- Harvey, C. R., Liu, Y., & Zhu, H. (2016) — "... and the Cross-Section of Expected Returns", The Review of Financial Studies, 29(1), 5–68.
- López de Prado, M. (2018) — Advances in Financial Machine Learning, John Wiley & Sons (chapitres sur le Purged K-Fold Cross-Validation et la probabilité de surapprentissage d'un backtest).
- Bailey, D. H., Borwein, J., López de Prado, M., & Zhu, Q. J. (2017) — "The Probability of Backtest Overfitting", Journal of Computational Finance, 20(4), 39–69.
Avertissement analytique : Les exemples de code et formules économétriques présentés dans cet article ont un but strictement éducatif et méthodologique. Les performances simulées par backtest ne garantissent en aucun cas les résultats futurs et ne constituent pas un conseil en investissement.
Analyseur de Backtest & DSR
Mesurez Deflated Sharpe Ratio, validation Monte Carlo et biais de sélection directement sur vos séries de rendements.
Analyser un backtestAuteur & Responsable Méthodologique
Alain Legrand
Fondateur & Ingénieur Financier Quantitatif · TrueVerdikt
Ingénieur financier indépendant basé au Québec (Canada), Alain Legrand conçoit et audite les modèles déterministes de TrueVerdikt : comparaison des frais RFG Série A/F et FNB TSX, arbitrage fiscal REER/CELIAPP, actuariat hypothécaire canadien et détection statistique du surapprentissage (Deflated Sharpe Ratio & CPCV).
Sources primaires & références vérifiées
- BSIF (OSFI) — Ligne directrice B-20 — Pratiques et procédures saines en matière de souscription de prêts hypothécaires résidentiels et test de tension (stress-test).
- ARC (CRA) — CELIAPP, REER & RAP — Plafonds officiels de cotisation (8 000 $/an, 40 000 $ à vie pour le CELIAPP), déductions fiscales et règles du RAP.
- CIFSC — Comité des normes des fonds d'investissement du Canada — Catégorisation normalisée des fonds communs de placement et FNB canadiens utilisée dans notre comparateur RFG.
- Bailey & López de Prado (2014) — The Deflated Sharpe Ratio — Correcting for Selection Bias, Backtest Overfitting, and Non-Normality. The Journal of Portfolio Management, 40(5), 94–107 (SSRN).
FNB à effet de levier NVIDIA (NVDL, NVDX) : Mathématiques du volatility decay et simulation Python du sell-off de -14 %
Fonds d'Investissement au Canada : Comment les Frais de Gestion (RFG) des 6 Grandes Banques Sabotent Votre Portefeuille (et Comment les Comparer)